INDUSTRY
製造業のデジタルツインとは?フィジカルAIとの関係と導入課題
製造業のデジタルツインとは、製品・設備・工場といった現実の製造要素を仮想空間に再現し、センサーデータで現実と同期させながら、監視・予測・最適化に使う仕組みです。近年は、この仮想空間がロボットや自律機械を動かす「フィジカルAI」の訓練場としても使われ始めています。
ただし、デジタルツインもフィジカルAIも、動かし続けるほどデータが増えます。センサーログ、カメラ映像、シミュレーション結果、学習用データセット、モデルの世代管理。これらをどこに置き、どう動かすかが、情報システム部門にとっての実務課題です。この記事では、仕組みと最新動向に加えて、データの保管・移動方法まで解説します。
記事のポイント:
製造業のデジタルツインの定義と、シミュレーションやメタバースとの違い
デジタルツインがフィジカルAIの学習・検証の基盤になる理由
2026年版ものづくり白書の数値から見た、データ活用の現在地と導入課題
シミュレーションやAI学習で増え続けるデータを、コストを見通しやすい形で保管・移動する方法
製造業のデジタルツインとは
製造分野の国際規格ISO 23247シリーズでは、デジタルツインを「製品・設備・生産ライン・工場などの製造要素をデジタルで表現し、現実と同期させるもの」と定義しています。あわせて、監視・制御・最適化といった目的ごとの枠組みも示しています。
言い換えると、CADモデルや3D空間があるだけではデジタルツインとは呼べません。現実の設備からセンサーやPLC(設備を制御する装置)からデータが流れ込み、仮想側の状態が現実に追従し、仮想側の分析結果が現実の運用に返る。この「同期」と「フィードバック」があって初めてデジタルツインになります。
シミュレーションやメタバースとの違い
デジタルツインとシミュレーション、メタバースは混同されやすいものの、現実との同期の有無と目的が異なります。
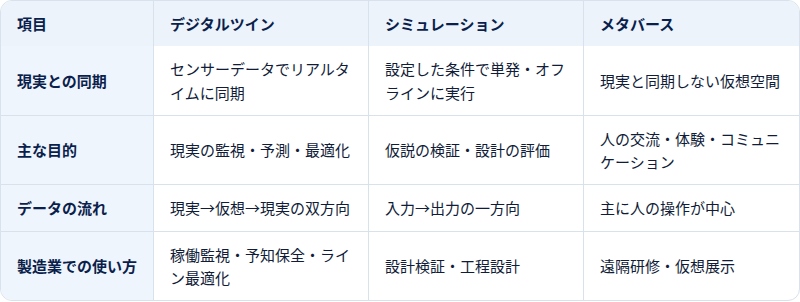
シミュレーションはデジタルツインの構成要素の1つであり、対立する概念ではありません。つまりデジタルツインは、現実と常につながったモデルの上でシミュレーションを回し続ける仕組みだといえます。
製造業で再現される対象の3階層
製造業のデジタルツインは、再現する対象の粒度によって3つの階層に分けて考えられます。
製品ツイン:製品そのものの設計・性能・使用中の状態を再現する。設計検証や出荷後の稼働監視に使う
設備・ラインツイン:工作機械、ロボット、搬送装置、生産ラインの挙動を再現する。予知保全やレイアウト検証、ロボットの動作教示に使う
工場・サプライチェーンツイン:工場全体や複数拠点、調達から出荷までの流れを再現する。生産計画の最適化やボトルネックの発見に使う
階層が上がるほど扱うデータの種類と量が増え、部門やシステムをまたいだデータ統合が必要になります。後述する導入課題の多くは、この階層をまたぐ場面で発生します。
2026年に製造業でデジタルツインが注目される背景
2026年に製造業でデジタルツインが注目される最大の理由は、データは集めていても成果につなげられていない企業が多いことです。デジタルツインは、ばらばらのデータを1つのモデルにまとめて活用する手段として期待されています。
経済産業省・厚生労働省・文部科学省がまとめた2026年版ものづくり白書(2026年5月閣議決定)には、次のような数値が示されています。
製造現場のデータを取得している事業者は66.0%、活用しているのは51.4%、効果が得られたのは43.9%と、段階が進むほど割合が下がるデータを取得・活用している事業者のうち、エンジニアリング・プロダクション・サプライ・サービスの各チェーンの中でデータ連携している企業は25〜31%程度ある一方、すべてのチェーン間で連携している企業は数%程度にとどまる
ベテランノウハウの見える化や技能継承の課題として「知識や経験の形式知化が難しい」を挙げた事業者は68.6%
中小企業でデジタル技術活用の戦略を策定済み・策定中なのは18.2%にとどまり、策定の予定もない企業が55.0%を占める
白書の数字をひと言でいえば「データは取れているが、つながっていない」状態です。設備や部門ごとにデータがあっても、互いにつながっていなければ予測や最適化には使えません。
政策面でも追い風があります。2026年7月に閣議決定された人工知能基本計画(第Ⅱ期)は、2025年12月の第Ⅰ期計画を引き継ぎ、工場の自律制御や人と協働するロボットなど、現実世界で物理的なタスクを実行するAI、すなわちフィジカルAIの研究開発と実証を戦略的に促進する方針を掲げています。ものづくりに強い日本の産業構造を生かし、ソフトウェア以外の分野で競争力を高める狙いがあります。
海外でも動きは速く、2026年1月のCES 2026ではSiemensとNVIDIAが、設計から製造・運用までを1つのAI基盤でつなぐ「Industrial AI Operating System」構想を発表しました。デジタルツインで検証した最適な設定を、そのまま実際の設備に反映できるようにする取り組みです。
デジタルツインとフィジカルAIの関係
デジタルツインとフィジカルAIの関係は、「訓練場と訓練生」の関係にたとえられます。フィジカルAIはデジタルツインの中で学習と検証を繰り返し、その成果を現実の設備やロボットに持ち込みます。そして現実で得た新しいデータが、再びデジタルツインに戻って次の学習に使われます。
フィジカルAIとは
フィジカルAIとは、センサーで周囲の状況を認識し、自ら判断してロボットや機械を物理的に動かすAIのことです。文章や画像を作る生成AIとの違いは、出力が「言葉」ではなく「動作」である点にあります。製造業では、部品のピッキング、組立、検査、搬送、段取り替えといった作業をAIが担う形で実装が進んでいます。
フィジカルAIが生成AIより難しいのは、学習データを現実世界から集めるコストが桁違いに高いからです。文章や画像はインターネット上に大量にありますが、「ロボットがこの部品をこう掴んだらこうなった」という動作データは、実機を動かして集めるしかありません。失敗すれば設備が壊れ、人に危険が及ぶ可能性もあります。
「フィジカルAIの訓練場」となるデジタルツイン
この課題を解決するのがデジタルツインです。物理法則を再現した仮想空間の中であれば、ロボットを何千回でも安全に失敗させられます。仮想空間で学習したモデルを現実に転移させる手法はSim2Real(シム・トゥ・リアル:仮想から現実へ)と呼ばれ、フィジカルAI開発では一般的な方法です。
デジタルツインがフィジカルAIに提供するものは、主に次の3つです。
合成データ(仮想空間で人工的に作る学習用データ)の生成:仮想空間で照明・配置・部品の姿勢を変えながら、学習用の画像や動作データを大量に自動生成する
安全な試行錯誤:実機を止めずに、危険な状況や稀な異常を含めて学習・検証を繰り返す
実機投入前の検証:現実の設備を再現した空間で、AIの判断が生産ラインに与える影響を事前に確かめる
現実と仮想を往復するデータの循環
フィジカルAIを支えるデータの循環は、
現実の設備・ロボットからセンサーデータや映像を収集する
デジタルツインを更新し、合成データを含む学習用データセットを作る
GPU(AIの計算に使う高性能な処理装置)を備えた計算環境でモデルを学習・評価する
学習済みモデルを実機に配備する
実機の動作ログが再び①に戻る
という5段階で回り続けます。
この循環で重要なのは、どの段階のデータも捨てにくいことです。学習に使った元データは、後からモデルの挙動を検証・監査するために残す必要があります。合成データも、どの条件で生成したかを含めて保持しておかなければ再現できません。つまりフィジカルAIを導入するなら、この循環を支えるデータ基盤が欠かせません。
製造業におけるデジタルツインの主な活用例
製造業での主な活用例は、次の5つです。
予知保全:設備の振動・温度・電流の時系列データをツインに反映し、異常の兆候を検知して故障前に部品交換を計画する
ライン設計・レイアウト検証:新ラインや設備の配置換えを仮想空間で試し、サイクルタイムやボトルネックを実機導入前に確認する
品質改善:加工条件と検査結果を結びつけ、不良の原因となる条件を仮想空間で特定する
ロボットの動作教示・自律化:フィジカルAIの学習と検証をデジタルツイン上で行い、段取り替えや多品種対応の負担を減らす
技能伝承:熟練者の作業をセンサーと映像で記録し、ツイン上で分析・可視化して形式知に変える
どの用途でも、始めた瞬間からデータが蓄積されます。特にロボット教示と品質改善は映像を扱うため、データ量が他の用途よりはるかに多くなります。この点が、次に述べる導入課題につながります。
製造業がデジタルツイン導入で直面する4つの課題
製造業のデジタルツイン導入でつまずきやすいのは、技術そのものよりも、データの統合・モデルの精度維持・人材と費用・蓄積データの保管という4つの実務面です。
課題1:現場データの収集と統合
最初の壁は、設備ごとに異なる通信方式やデータ形式を1つに統合することです。古い工作機械にはネットワーク接続がなく、後付けセンサーが必要な場合もあります。前述のとおり、すべてのチェーン間でデータ連携できている企業は数%程度にとどまり、多くの企業はこの段階で止まっています。
生産設備を扱うOT(制御技術)部門と、システムを扱うIT部門の間で、責任範囲や優先順位が異なることも統合を難しくします。企画の段階から、両部門が一緒に検討できる体制を作っておきましょう。
課題2:モデルの精度と同期の維持
デジタルツインは作って終わりではなく、現実との同期を維持し続ける必要があります。設備の経年変化、治具の交換、レイアウトの変更が起きるたびに、仮想側のモデルも更新しなければ、シミュレーション結果が現実からずれていきます。
フィジカルAIではこの問題がさらに深刻です。仮想空間と現実のずれ(Sim2Realギャップ)が大きいと、仮想で学習したモデルが実機でうまく動きません。ギャップを埋めるには、現実の稼働データを継続的に取り込み、モデルを再学習し続ける運用が必要です。
課題3:人材と費用の確保
2026年版ものづくり白書では、AI・デジタル技術活用の課題として「知識やノウハウの取得」を挙げた事業者が57.2%、「導入に必要な人材の確保」が47.9%と、この2つが上位を占めています。デジタルツインは製造技術、データ分析、ITインフラの3つの分野にまたがるため、すべてを社内でまかなうのは難しく、外部パートナーに頼りがちです。
費用面では、初期のセンサー設置やソフトウェアライセンスだけでなく、運用を続けるほど増えるデータ保管費と計算資源費を見積もっておく必要があります。初期費用だけで判断すると、2年目以降にランニングコストが予算を圧迫します。
課題4:蓄積されるデータの保管と移動
見落とされがちですが、運用が長くなるほど負担が大きくなるのが、データの置き場所と動かし方です。
どれくらいのデータが増えるのか、簡単に試算してみます。仮に、生産ラインの品質検査とロボット教示のために4Kカメラを10台設置し、1台あたり約20Mbpsで1日8時間録画するとします。1台1時間で約9GB、1日で約72GB、10台で1日約720GBです。月20日稼働なら、映像データだけで毎月約14TB増える計算になります。ここにセンサーの時系列データ、シミュレーション結果、合成データ、モデルの世代ごとのファイルが加わります。
このデータには、次のような特徴があります。
一度書いたら消せないものが多い:学習に使った元データやモデルの世代は、検証・監査のために長期保持が必要になる
読み出しの頻度が読めない:再学習や検証のたびに、過去のデータセットをまとめてGPU基盤へ送る必要がある
置き場所が分散しやすい:工場のエッジ、社内サーバー、クラウドのGPU基盤と、データが往復する
従来型のクラウドストレージでは、データを読み出すたびに、クラウドの外へデータを取り出す料金(下り転送料)と、読み書きの操作ごとにかかる料金(APIリクエスト料)が発生します。上記のように毎月十数TBが増え、しかも再学習のたびに過去データを読み出す使い方では、保存料より転送料のほうが大きくなる場合もあります。これが、デジタルツインやフィジカルAIのデータ基盤で「コストが読めない」と言われる主な理由です。
デジタルツインとフィジカルAIのデータを保管・移動する方法
デジタルツインとフィジカルAIのデータ基盤の中心には、次の3条件を満たす保管先を選ぶのがおすすめです。①保存量だけで費用が決まる、②読み出しに追加料金がかからない、③S3互換で既存ツールとつながる。そうすれば、運用が長くなっても費用を見通しやすくなります。以下では、データの整理、保管先の比較、移動手段の順に説明します。
データの種類別に見る保持期間と読み出し頻度
最初にやるべきことは、扱うデータを種類ごとに分け、保持期間と読み出し頻度を決めることです。全部を同じ扱いにすると、高価なストレージに不要なデータまで置いてしまったり、逆に必要なデータをすぐに取り出せなかったりします。
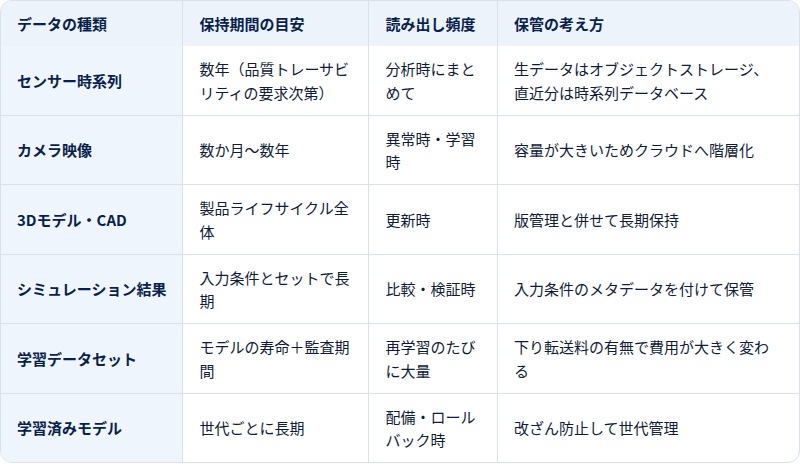
表を見ると、「長く残し、ときどきまとめて読み出す」データが多いことが分かります。こうしたデータには、保存量だけに課金され、読み出し料金がかからないストレージが向いています。
保管先の選び方:オンプレミス・ハイパースケーラー・Wasabiの比較
保管先の候補は、オンプレミスのストレージ、AWS S3などの大手クラウド(ハイパースケーラー)、そしてWasabiのような単一料金のクラウドオブジェクトストレージの3つです。フィジカルAIのデータ基盤という観点で比較します。
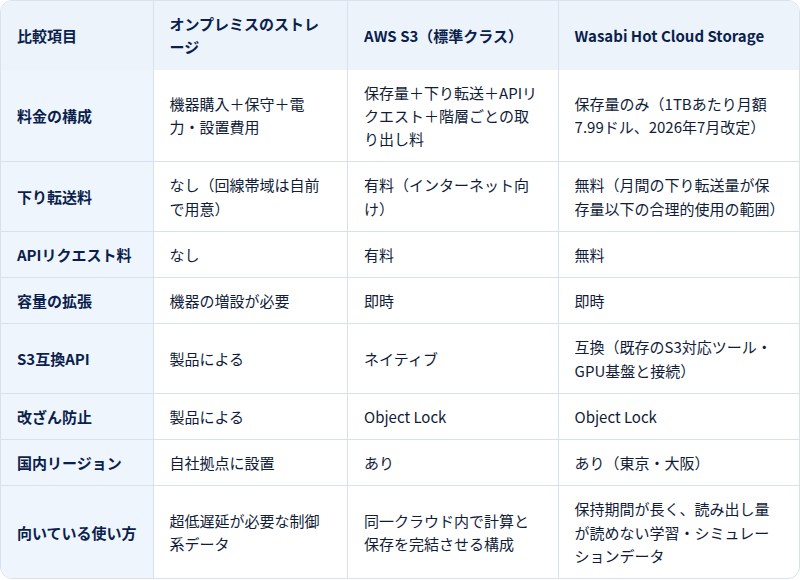
3つから1つを選ぶ必要はありません。実際には、制御系の直近データはエッジやオンプレミスに置き、GPU計算は必要なときだけクラウドや専用基盤で回し、蓄積データの本体は単一料金のオブジェクトストレージに置く、という組み合わせが現実的です。WasabiはAI/ML向けのストレージとして、S3互換APIを通じてあらゆるGPU基盤やクラウドにデータを供給できる設計になっており、数ペタバイト(1PB=1,000TB)規模のAI用データ保管庫としての運用実績もあります。
注意点も書いておきます。Wasabiは、すぐに読み出せる1種類の保存方式のみを提供しており、AWS S3のような複数の保存階層は持ちません。また下り転送料の無料には、月の下り転送量が保存量を超えないという利用条件(合理的使用ポリシー)があります。毎月保存量の何倍ものデータを読み出す使い方には向きません。最低保存期間や最低課金容量の条件もあるため、短期間だけ置いて消す一時データの置き場には別の選択肢が適しています。
データを移動する4つの手段
保管先を決めたら、工場・社内・クラウドの間でデータをどう動かすかを設計します。手段は主に4つです。
インターネット経由でS3 APIを使って転送する:バックアップソフト、rcloneなどのツール、AIフレームワークのS3コネクタから直接書き込む。日々増えるセンサーデータや映像の定常的な転送に向く
専用線・プライベート接続を使う:拠点やデータセンターからクラウドへ高速かつ安定した回線を引く。数十TB単位の継続的なアップロードがある場合に検討する
物理アプライアンスで搬送する:Wasabiでは最大250TBを格納できるWasabi Ball Transfer Applianceが用意されており、回線が細い工場や初回の大量移行に使える。提供状況はリージョンによって異なるため事前確認が必要
ストレージの自動複製(レプリケーション)機能を使う:バケット間の複製機能で、災害対策用の第2リージョンへ自動的にコピーする
GPU環境へ学習データを送ったり、検証のために過去データを社内に戻したりと、クラウドから取り出す機会が多いほど、転送料無料のメリットが大きくなります。初回移行や移行後の運用設計については、Wasabiへのクラウドデータ移行のページでも解説しています。
導入事例:ロボット基盤モデル開発における2.2PBデータハブの運用
フィジカルAIのデータ基盤としてWasabiが使われている事例に、日本の非営利組織AIロボット協会(AIRoA)があります。同協会は、小売・製造・物流などの現場から集めた実世界データを統合し、ロボットの基盤モデルを開発・学習する「データハブ」をWasabi Hot Cloud Storage上に構築しました。
課題は3つありました。継続的に数十TB単位のデータをアップロードし続ける必要があること、アップロード・保存・ダウンロードのどの段階でもデータが欠けてはならないこと、そして非営利組織として変動費を避けたいことです。検証段階でテラバイト級のデータ処理と転送速度を確認したうえで採用され、2026年3月時点で2.2PBを超えるデータを保存しています。下り転送料とAPIリクエスト料がかからないことで、他のプロバイダーと比べて1億円を超える費用低減が見込まれています(Wasabi導入事例:AIRoA、英語)。
この事例でコメントを寄せている東京大学の研究者は、Wasabiの製造業向けソリューションページでも「AIで何かするのなら、データはすべて保存することを勧める」という趣旨の発言をしています。フィジカルAIでは、どのデータが後で役立つか最初は分かりません。そのため、全部残せる前提で基盤を作っておくべきだという指摘です。
自社の映像データやシミュレーション結果を使って、転送速度や既存ツールとの接続を試したい場合は、Wasabiの30日間無料トライアルが入口になります。クレジットカード不要で、まずは実データの一部を置いてみることをお勧めします。
情シス担当者がデジタルツイン基盤を検討するときのチェックリスト
デジタルツインやフィジカルAIの企画が現場や経営から降りてきたとき、情報システム部門が最初に確認すべき項目を整理しました。技術選定の前に、この10項目を埋めておくと後戻りが減ります。
対象範囲:製品・設備/ライン・工場のどの階層から始めるか決まっているか
データ源:対象設備からどの方式(OPC UA、PLC直結、後付けセンサー、カメラ)でデータを取るか把握しているか
OTとITの体制:制御側と情報システム側の責任分担と窓口が決まっているか
データ量の見積もり:映像・センサー・シミュレーション・学習データについて、月あたりの増加量を試算したか
保持期間:データの種類ごとに、いつまで残すかを決めたか
読み出しの見込み:再学習や検証のために、どれくらいの頻度で過去データを取り出すかを想定したか
費用の構造:保存量以外に、下り転送・APIリクエスト・階層間の取り出しに料金がかかる構成になっていないか
接続性:候補のストレージが、使うAIフレームワーク・CAE・バックアップ製品とS3 APIで接続できるか
改ざん防止と監査:学習データとモデルの世代を、Object Lock(一定期間データを変更・削除できなくする機能)などで保護し監査に耐える形で残せるか
出口戦略:データが特定のクラウドに囲い込まれず、必要なら別基盤へ持ち出せるか
中堅企業で情シスが1〜2名の場合は、10項目すべてを自社で埋めようとせず、「データ量の見積もり」「保持期間」「費用の構造」の3つだけ先に固めることを勧めます。この3つが決まれば、ベンダーやシステム開発会社(SIer)に対して具体的な要件として提示でき、提案の比較がしやすくなります。
製造業のデジタルツインに関するよくある質問
Q. デジタルツインとフィジカルAIは、どちらを先に導入すべきですか?
A. 順序としてはデジタルツインが先です。フィジカルAIの学習と検証には、現実の設備や環境を再現した仮想空間が必要になります。ただし、いきなり工場全体を再現する必要はありません。1台のロボットや1つの工程を対象にした設備ツインを作り、そこでフィジカルAIの小さな実証を回すところから始めると、データ基盤の要件も具体的に見えてきます。
Q. デジタルツインのデータは、どれくらいの期間残すべきですか?
A. データの種類によって異なります。学習に使った元データと学習済みモデルは、後からAIの判断根拠を検証・説明するために、モデルを使い続ける期間に監査対応の期間を加えて残すのが一般的です。センサーの時系列データは製品の品質トレーサビリティの要求に合わせます。いずれも「後から必要になる可能性がある」データが多いため、削除を前提にせず、長期保持しても費用を見通せる保管先を選ぶことが重要です。
Q. 映像やシミュレーション結果をクラウドに置くと、取り出すたびに費用がかかりますか?
A. ストレージによって異なります。AWS S3などの従来型では、インターネット向けの下り転送とAPIリクエストに料金が発生し、階層によっては取り出し自体に料金がかかります。Wasabiは保存量だけに課金され、月間の下り転送量が保存量以下という合理的使用の範囲であれば、下り転送料もAPIリクエスト料もかかりません。再学習や検証で過去データをまとめて読み出す使い方では、この違いが費用に直結します。
Q. 中小の製造業でもデジタルツインは現実的ですか?
A. 対象を絞れば現実的です。2026年版ものづくり白書では、中小企業でデジタル技術活用の戦略を策定済み・策定中なのは18.2%にとどまり、まだ本格的に取り組んでいない企業が多いのが実情です。そのため、まずは小さく始めるのがおすすめです。特定の設備の予知保全や、1工程のレイアウト検証など、効果を測りやすいテーマから始め、蓄積したデータを次のテーマに使い回すとよいでしょう。
Q. 既存のシミュレーションソフトやバックアップ製品はそのまま使えますか?
A. S3互換のAPIに対応していれば、多くの場合そのまま使えます。CAEやデジタルツイン基盤、AIフレームワーク、バックアップ製品の多くはS3対応のストレージ接続機能を持っています。WasabiはS3互換のオブジェクトストレージであるため、接続先のURL(エンドポイント)とアクセスキーを切り替えるだけで利用できるケースがほとんどです。ただし製品ごとの対応状況は事前に確認してください。
製造業のデジタルツインとフィジカルAIのまとめ
製造業のデジタルツインとは、製品・設備・工場を仮想空間に再現し、センサーデータで現実と同期させながら監視・予測・最適化に使う仕組みである
シミュレーションとの違いは現実との同期と双方向のフィードバックにあり、シミュレーションはデジタルツインの構成要素の1つである
フィジカルAIはデジタルツインを訓練場として学習・検証を繰り返し、現実で得たデータが再び仮想空間に戻る循環で精度を高める
2026年版ものづくり白書では、データを取得する企業66.0%に対し効果を得た企業は43.9%にとどまり、すべてのチェーン間で連携する企業は数%程度である
導入課題はデータ統合・モデルの同期維持・人材と費用・蓄積データの保管の4つで、運用が長期化するほど保管と移動の設計が費用を左右する
学習・シミュレーションデータは保持期間が長く読み出しが不定期にまとまるため、保存量だけで費用が決まりS3互換で接続できる保管先が基盤の中核に適している
デジタルツインのデータ基盤を、費用を見通せる形で始める
デジタルツインもフィジカルAIも、長く続けるほどデータが資産になります。だからこそ、データ基盤は「すべて残しても費用を見通せる」ことを最初の条件にしましょう。
Wasabi Hot Cloud Storageは、保存量だけに課金され、下り転送料とAPIリクエスト料がかからない、S3互換のクラウドオブジェクトストレージです。東京・大阪のリージョンを持ち、Object Lockによる改ざん防止にも対応しています。自社のデータ量で費用を試算したい、既存のツールやGPU基盤との接続を確認したい場合は、お問い合わせ・資料請求からご相談ください。まず実データで試したい場合は、30日間無料トライアルをご利用いただけます。
データ基盤の全体設計を整理したい方は、同ブログのデータ基盤の構築手順5ステップも併せてご覧ください。
自社のデータで、転送速度と接続を試してみませんか
Wasabiの30日間無料トライアルなら、クレジットカード不要ですぐに始められます。映像やシミュレーション結果の一部を置いて、既存のツールやGPU環境から読み書きできるかを確かめてください。

ランサムウェアはバックアップと復旧経路そのものを狙う時代へ。不変性だけでは守れない今、WasabiのCovert Copy™は論理的エアギャップで最後のクリーンなコピーを不可視化し、確実な復旧を実現します。詳細は近日開催のウェビナーで。
データレイク構築の手順を5ステップで解説。Raw・Cleansed・Curatedのゾーン設計、S3互換ストレージの選定基準、データスワンプを防ぐ運用まで、AI活用を見据えた実装のポイントを整理します。
クラウドストレージにおける責任共有の実践的な整理。プロバイダーが担当する内容と、リスクを低減しインシデント対応を迅速化するために顧客が管理すべき内容を含みます。アクセス制御、保持、変更不可性、暗号化、および Covert Copy を扱います。